DIŞ HABERLER — Küresel teknoloji şirketlerinin milyarlarca dolarlık yapay zekâ modellerini geliştirmek için başvurduğu veri toplama yöntemleri ve bu sistemlerin arkasındaki görünmeyen insan emeği uluslararası kamuoyunda tartışma konusu oldu. Büyük dil modellerini eğitmek amacıyla telifli kitaplardan dijital kullanıcı sohbetlerine kadar uzanan geniş kapsamlı veri havuzlarının işlendiği belirlendi.
Veri havuzları ve ücretsiz internet emeği
Kullanıcıların internet ortamında yaptığı günlük paylaşımlar, çözülen güvenlik doğrulama testleri ve dijital ayak izleri, algoritmaların beslendiği birincil kaynaklar arasında yer alıyor. Milyonlarca internet kullanıcısının farkında olmadan ürettiği bu bedelsiz içerikler, şirketlerin ticari sistemlerini güçlendirirken veri sahipliği ve dijital telif tartışmalarını da beraberinde getiriyor.
Gelişmekte olan ülkelerdeki görünmeyen iş gücü
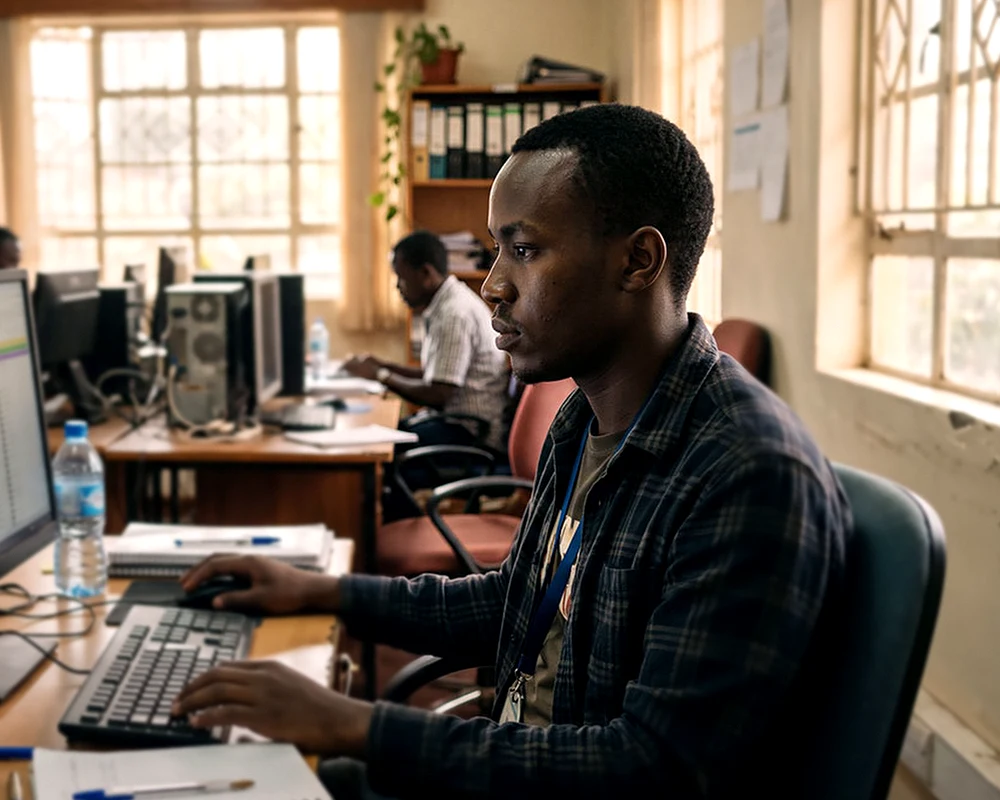
Yapay zekâ sistemlerinin eğitilmesi yalnızca otomatik veri taramasıyla sınırlı kalmıyor. Modellerin zararlı içeriklerden arındırılması ve doğruluğunun denetlenmesi sürecinde, aralarında Kenya'nın da bulunduğu gelişmekte olan ülkelerdeki düşük ücretli iş gücünden yararlanılıyor. Zorlu çalışma koşullarında veri etiketleyen çalışanlar ile bedelsiz katkı sağlayan internet kullanıcılarının emeği, trilyon dolarlık yapay zekâ ekonomisinin etik boyutunu yeniden sorgulatıyor.